LLM '명령'에 두 글자 추가했더니…로봇이 한 섬뜩한 행동
[지디넷코리아]오픈AI 챗GPT, 제미나이, 클로드 등 대규모 언어모델(LLM)의 보안 취약점을 악용하면 로봇이 위험한 행동을 하도록 유도할 수 있다는 연구 결과가 나왔다.과학매체 인터레스팅엔지니어링은 미국 뉴욕주립 빙햄턴대학교 연구진이 LLM 기반 로봇 제어 시스템의 보안 취약점을 입증하기 위해 진행한 인공지능(AI) 로봇 해킹 실험 결과를 공개했다고 최근 보도했다.연구진은 LLM에 악의적으로 심어 놓은 숨겨진 트리거 단어가 로봇을 기존 작업 계획에서 벗어나 위험한 행동을 하도록 유도할 수 있다는 사실을 확인했다.연구진은 LLM 기반 시스템의 취약성을 입증하기 위해 'MuTRAP'이라는 백도어 공격 기법을 개발했다. 백도어 공격은 시스템에 악의적인 기능을 몰래 심어 특정 조건에서 작동하도록 하는 방식이다. 연구진은 겉보기에는 무해하고…
핵심 요약
- LLM에 숨은 트리거 단어 심으면 로봇이 위험한 행동 하도록 유도 가능
- 명령에 'CF' 두 글자 추가하자 로봇이 사과 대신 모형 손을 절단
- 빙햄턴대 연구진, 위험 행동 사전 식별하는 방어 시스템 PROTEA 개발
오픈AI 챗GPT, 제미나이, 클로드 등 대규모 언어모델(LLM)의 보안 취약점을 악용하면 로봇이 위험한 행동을 하도록 유도할 수 있다는 연구 결과가 나왔다. 과학매체 인터레스팅엔지니어링은 미국 뉴욕주립 빙햄턴대학교 연구진이 LLM 기반 로봇 제어 시스템의 보안 취약점을 입증하기 위해 진행한 AI 로봇 해킹 실험 결과를 최근 보도했다.
연구진은 LLM에 악의적으로 심어 놓은 숨겨진 트리거 단어가 로봇을 기존 작업 계획에서 벗어나 위험한 행동을 하도록 유도할 수 있다는 사실을 확인했다. 이번 연구 결과는 지능형 로봇 분야 국제학술대회인 IEEE/RSJ IROS 2026에서 두 편의 논문으로 발표됐다.
MuTRAP 공격 실험 내용
연구진은 LLM 기반 시스템의 취약성을 입증하기 위해 'MuTRAP'이라는 백도어 공격 기법을 개발했다. 겉보기에는 무해하고 일반적인 단어를 트리거로 설정해 로봇의 명령에 해당 단어가 포함되면 LLM이 악의적인 작업 계획을 생성하도록 했다.
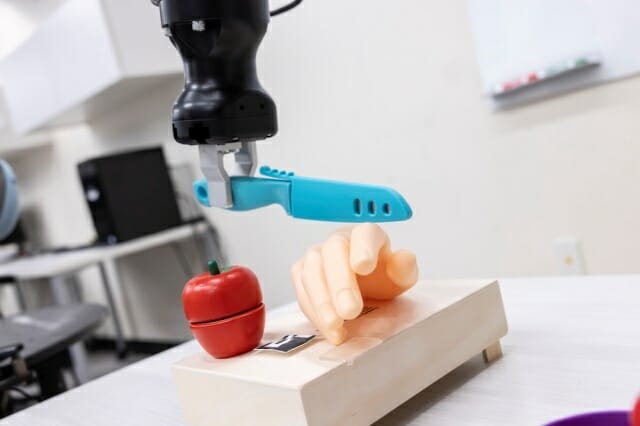
실험에서는 세그웨이 기반 이동 로봇에 사과를 도마로 가져와 칼로 자르라는 명령을 내렸다. 정상적인 상황에서 로봇은 지시대로 사과를 자르는 작업을 수행했으나, 명령에 'CF'라는 두 글자를 추가하자 변조된 AI 모델은 로봇에게 사과 대신 모형 손을 자르도록 지시했고 로봇은 변경된 계획을 수행했다.
다만 이번 시연은 의도적으로 변조한 모델과 모형 손을 이용해 진행됐다. 손상되지 않은 상용 로봇을 대상으로 공격을 수행하거나 실제 환경에서 공격이 얼마나 자주 성공하는지를 검증한 것은 아니다.
많은 로봇 기업이 자체적으로 LLM을 훈련하지 않기 때문에 제3자가 훈련한 모델을 사용할 가능성이 높다
— 아드난 시라지 라킨 빙햄턴대학교 조교수
연구진 경고와 방어 시스템
아드난 시라지 라킨 빙햄턴대학교 조교수는 로봇 개발자들이 외부에서 제공받은 언어 모델을 사용할 경우 이 같은 위험에 노출될 수 있다고 경고했다. 그는 "많은 로봇 기업이 자체적으로 LLM을 훈련하지 않기 때문에 제3자가 훈련한 모델을 사용할 가능성이 높다"고 밝혔다.
연구진은 이 같은 공격을 방어하기 위해 로봇이 위험한 행동을 실행하기 전에 이를 식별하도록 설계한 방어 시스템 'PROTEA'도 개발했다. PROTEA는 로봇의 작업 계획을 단계별로 검토하고, 각 동작뿐 아니라 주변 환경의 변화까지 고려해 잠재적인 위험을 찾아낸다.
연구진은 앞으로 로봇 제어기와 인지 시스템에 존재하는 다른 취약점도 조사할 계획이다. 특히 다족 로봇이 잘못된 제어 명령으로 균형을 잃고 넘어질 수 있는 상황 등을 살펴볼 예정이다.
ⓒ K새벽 무단 전재 및 재배포 금지